在数字经济时代,数据已成为与土地、劳动力、资本、技术并列的生产要素。大数据工厂作为将原始数据转化为可行动洞察的工业化平台,正成为企业竞争力的关键来源。本文旨在系统综述大数据工厂的优势与实力,并提出一套适合商务洽谈与产品发布场景的大数据服务方案。\n\n## 一、大数据工厂的优势综述\n\n1. 规模化与成本效益\n 大数据工厂采用分布式存储与计算架构(如Hadoop、Spark、Flink),实现PB级数据的低成本存储与高效处理!相比传统数据仓库,单位计算成本下降60%以上。\n\n2. 端到端的数据流水线\n 从数据采集、清洗、加工、建模到服务化输出,形成标准化流水线。每个环节可复用、可监控、可治理,将数据准备周期从数周压缩至数天甚至小时级。\n\n3. 多源异构数据融合能力\n 支持结构化、半结构化、非结构化数据的统一接入与关联分析,打通业务孤岛。无论是日志、图像、语音还是交易记录,都能在统一平台上完成融合,形成360°数据视图。\n\n4. 弹性扩展与高可用\n 基于云原生或混合云部署,资源可随业务负载秒级弹性伸缩。多副本容错机制保障99.99%以上的服务可用性,满足关键业务连续性要求。\n\n5. 安全合规与数据治理\n 内置数据分级分类、脱敏加密、权限控制、审计追溯等能力,符合GDPR、个人信息保护法等法规要求。数据血缘与元数据管理让数据资产可见、可管、可信。\n\n## 二、实力彰显:技术栈与行业实践\n\n1. 技术底座\n - 计算引擎:Spark、Flink、Presto、Ray等,覆盖批流一体与AI训练;\n - 存储层:HDFS、对象存储、湖仓一体(Iceberg、Hudi);\n - 调度与编排:Airflow、DolphinScheduler、Kubernetes;\n - 数据治理:Atlas、DataHub、自研元数据中心;\n - AI平台:MLflow、 Kubeflow、大模型微调框架。\n\n2. 性能指标\n - 单集群日处理任务量:>50万;\n - 查询延迟:交互式分析<3秒,批处理TB级<30分钟;\n - 数据吞吐:单节点>1GB/s;\n - 任务成功率:>99.5%。\n\n3. 行业实践\n - 零售:用户画像与精准营销,GMV提升15%;\n - 金融:实时风控与反欺诈,欺诈损失下降40%;\n - 制造:设备预测性维护,非计划停机减少30%;\n - 政务:一网通办数据分析,办事效率提升50%。\n\n这些实践验证了大数据工厂在降本、增效、创新方面的硬核实力。\n\n## 三、面向洽谈与产品发布的大数据服务方案\n\n商务洽谈和产品发布是企业对外展示、促成合作、赢得市场的关键场景!我们推出“数智洞察”服务包,专为这两类场景定制从数据到决策的全链路支持。\n\n### 服
务一:商务洽谈数据助手\n- 客户360°画像:整合内外部数据(交易、行为、舆情、工商信息),生成谈判对象的决策链、偏好、痛点和风险提示\n- 竞品与市场动态实时看板:谈判前快速掌握行业均价、竞品策略、政策变化\n桌面端推
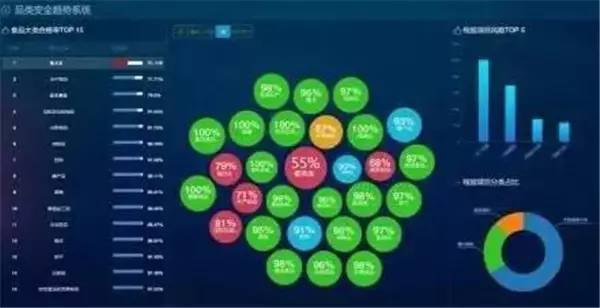
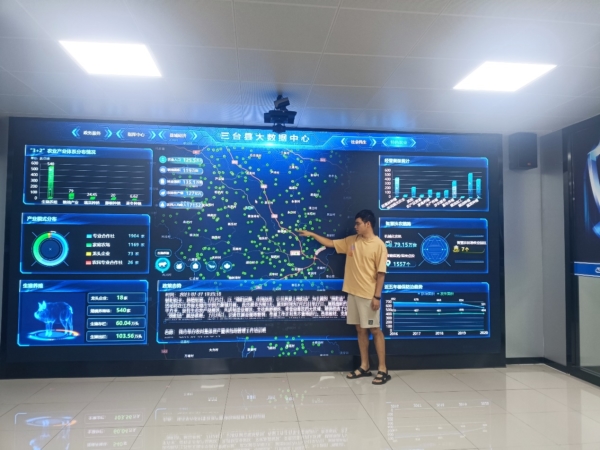
- 智能报价与利润模拟:基于历史成交与成本数据,提供阶梯报价建议,保障利润率\n工具对应word文档的word文档修改我要精简服\n务设计思想:提升洽谈专业度与成功率,让数据成为谈判桌上的“第五张牌”。\n\n### 服务二:产品发布数据支撑\n- 发布会实时数据大屏:展示产品预热阶段的预约量、社交声量、预售转化漏斗,并通过低
_delay 流视频输出品牌科技感:{实时关键词,热议区域一目了然:反哺媒体素材